
ローカルLLMでオリジナルAIキャラクターは作れる?ゲーミングPCで試してみた
こんにちは!ソリューションの増田洸多です。「AI」と聞くと、ChatGPTのようにインターネットの向こう側で動くサービスを思い浮かべる方が多いと思います。しかし実は、ゲーミングPCがあれば、AIを自宅のPCだけで動かす「ローカルLLM」を始めることができます。
そこで今回は、個人開発として「自分のゲーミングPCで、オリジナルのAIキャラクターは作れるのか」に挑戦してみました。まず第1回では、環境を作ってAIと日本語で会話するところまでと、キャラクターを作るための計画を紹介します。
ローカルLLMとは
LLM(大規模言語モデル)は、文章を読んで続きの文章を生成するAIです。例えば、ChatGPTなどの会話AIも、この仕組みを中心に作られています。
一方で「ローカルLLM」は、このLLMをクラウドではなく自分のPCで動かす使い方を指します。
| クラウドAI | ローカルLLM | |
|---|---|---|
| 動く場所 | サービス事業者のサーバー | 自分のPC |
| 会話データ | インターネットを通って送信される | PCの外に出さずに使える |
| 費用 | 月額料金や従量課金 | モデルは無料のものが多い(電気代はかかる) |
| 賢さ | 最上位の大規模モデルが使える | PCの性能で動かせる規模に限られる |
| 自由度 | サービスの範囲内 | モデルの入れ替えや設定を自由に試せる |
このように、会話を外に出さず、気兼ねなく試行錯誤できる点が特徴です。そのため、自分だけのキャラクターを育てる用途とも相性が良いと考えました。
なぜゲーミングPCが向いているのか
LLMの計算の大部分は、大量の掛け算と足し算を並べて行う処理です。そして、これはゲームの映像を描くためのGPU(グラフィックボード)が得意とする計算でもあります。
さらに重要なのが、GPUに搭載されているメモリ「VRAM」の容量です。なぜなら、モデルをVRAMに載せられるかどうかで、快適に動くかが大きく変わるからです。
例えば、今回使うQwen3は、Ollamaで次のサイズが公開されています(2026年11月時点、各サイズの標準タグ)。
| モデル | ダウンロードサイズ |
|---|---|
| qwen3:0.6b | 523MB |
| qwen3:1.7b | 1.4GB |
| qwen3:4b | 2.5GB |
| qwen3:8b | 5.2GB |
| qwen3:14b | 9.3GB |
| qwen3:30b | 19GB |
なお、「4b」「8b」はパラメータ(AIが学習で身につけた数値)の数で、40億個・80億個を意味します。ただし、実際に動かすときは、会話の長さなどに応じてファイルサイズより多くのVRAMを使います。したがって、「ファイルサイズがVRAMに余裕を持って収まるか」を最初の目安にすると分かりやすいです。
今回使った環境
今回使ったのは、特別な機材ではなく一般的なゲーミングPCです。
| パーツ | 構成 |
|---|---|
| OS | Windows |
| CPU | AMD Ryzen 7 9700X |
| GPU | NVIDIA GeForce RTX 4070 SUPER(VRAM 12GB) |
| メモリ | DDR5 32GB |
| ソフト | Ollama 0.40.14 |
| モデル | Qwen3 4B(qwen3:4b) |
まず、Ollamaは、ローカルLLMをダウンロードして動かすためのソフトです。次に、Qwen3はAlibabaのQwenチームが公開しているモデルで、日本語を含む100以上の言語に対応しています。つまり、「ゲーム機(Ollama)とゲームソフト(Qwen3)」のような関係だと考えると分かりやすいと思います。
実際にやってみた
手順は、次の3つだけです。
- まず、Ollama公式サイトからWindows版をダウンロードしてインストールする
- 次に、PowerShellでモデルをダウンロードする
- 最後に、モデルを起動して話しかける
# モデルをダウンロード(約2.5GB)
ollama pull qwen3:4b

# 起動して会話を始める
ollama run qwen3:4b
起動したら、あとは日本語で話しかけるだけで返答が返ってきます。実際に、今回の環境でも自然な日本語での会話に成功しました。
【画像:実際の会話画面のスクリーンショット】
また、Qwen3には、答える前に考える過程を出力する「Thinkingモード」と、すぐに答えるモードがあります。特にキャラクターとの会話では、この切り替えも応答の自然さに関わってきそうです。
AIキャラクターはどうやって作るのか
ただ、実際に試して分かった大事な点があります。それは、モデルを動かすだけでは、キャラクターにはならないということです。というのも、LLMはもともと、会話の内容を自動で記憶し続けたり、決まった性格を保ったりする仕組みではないからです。
そこで、次のような役割をアプリ側で組み合わせる構成を考えています。
- チャット画面:ブラウザから話しかける画面(Laravel / Livewireで作成予定)
- 人格設定:性格・口調・関係性をまとめた設定を、毎回AIに渡す
- 記憶:会話履歴や重要な出来事を保存し、必要なものを探してAIに渡す
- 感情・関係性:親密度や気分を数値で管理し、会話に応じて少しずつ変化させる
- 言語モデル:受け取った情報をもとに、キャラクターらしい返答を生成する(Ollama + Qwen3)
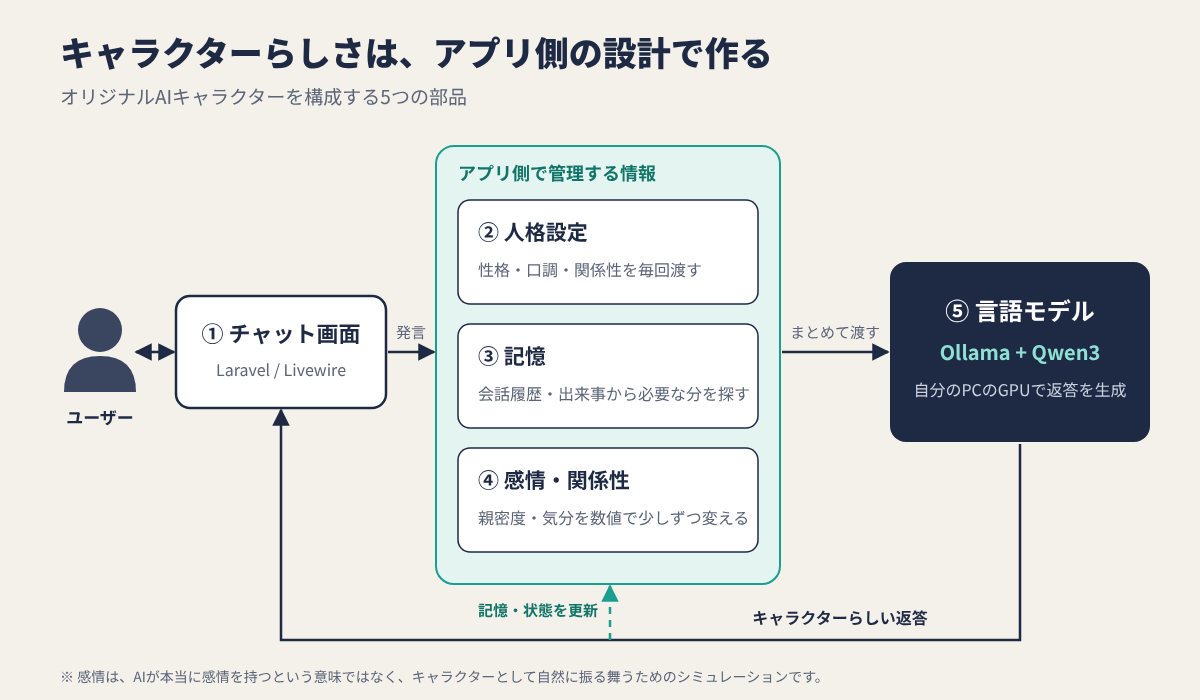
つまり、キャラクターの「らしさ」の多くは、モデルそのものよりも、モデルに何を渡すかという設計で決まります。なお、ここでいう感情は、AIが本当に感情を持つという意味ではありません。あくまで、キャラクターとして自然に振る舞うための仕組みです。
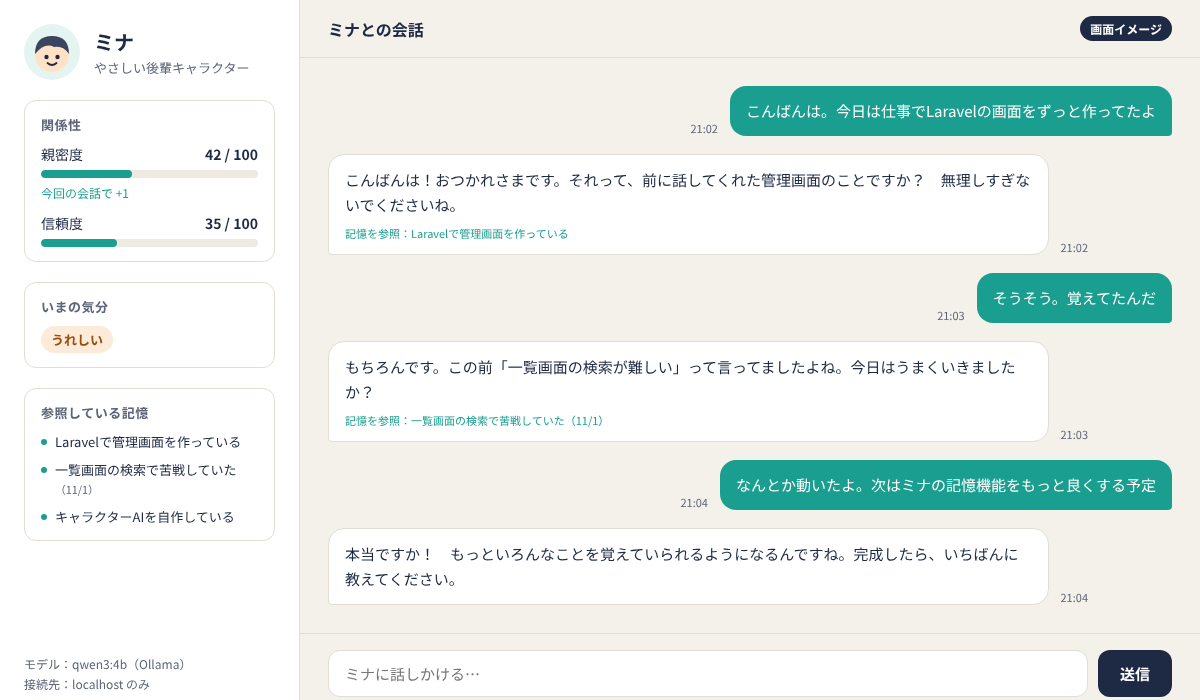
例えば、完成すると次のような画面を想定しています(画面はイメージです)。
その先の計画:AIそのものも作ってみたい
また、キャラクターAIづくりと並行して、次の2つにも挑戦する予定です。
- 追加学習(LoRA):既存のモデルにキャラクターの口調を学習させます。しかも、モデル全体ではなく一部だけを学習する方法なので、VRAM 12GBの範囲でも試せる可能性があります
- 小型LLMの自作:TransformerというLLMの基本構造を、PyTorchでゼロから実装します。ただし、目的は実用性よりも、AIが文章を作る仕組みを理解することです
始める前に知っておきたい注意点
- 外部に公開しない:Ollamaは初期設定では、自分のPC(127.0.0.1の11434番ポート)からだけ接続できます。そのため、別の端末から使うために設定を変える場合は、誰でも接続できる状態にならないよう注意が必要です
- ライセンスを確認する:モデルごとに利用条件があります。ちなみに、今回のQwen3-4BはApache 2.0ライセンスで公開されています
- 個人情報の扱い:会話履歴はPC内に残ります。したがって、記憶機能を作るときは、保存する内容と削除の方法も合わせて設計します
まとめ
このように、ゲーミングPCがあれば、オリジナルAIキャラクターの土台となる「ローカルLLM」は、無料のソフトと数本のコマンドで用意できます。一方で、性格や記憶を持ったキャラクターにするには、アプリ側の設計が欠かせません。
そこで次回は、GPUがどのように使われているかの確認と、キャラクター設定ファイルの作成に取り組む予定です。
参考(2026年11月5日確認):Ollama qwen3 tags、Qwen/Qwen3-4B(Hugging Face)、Ollama FAQ、Ollama for Windows